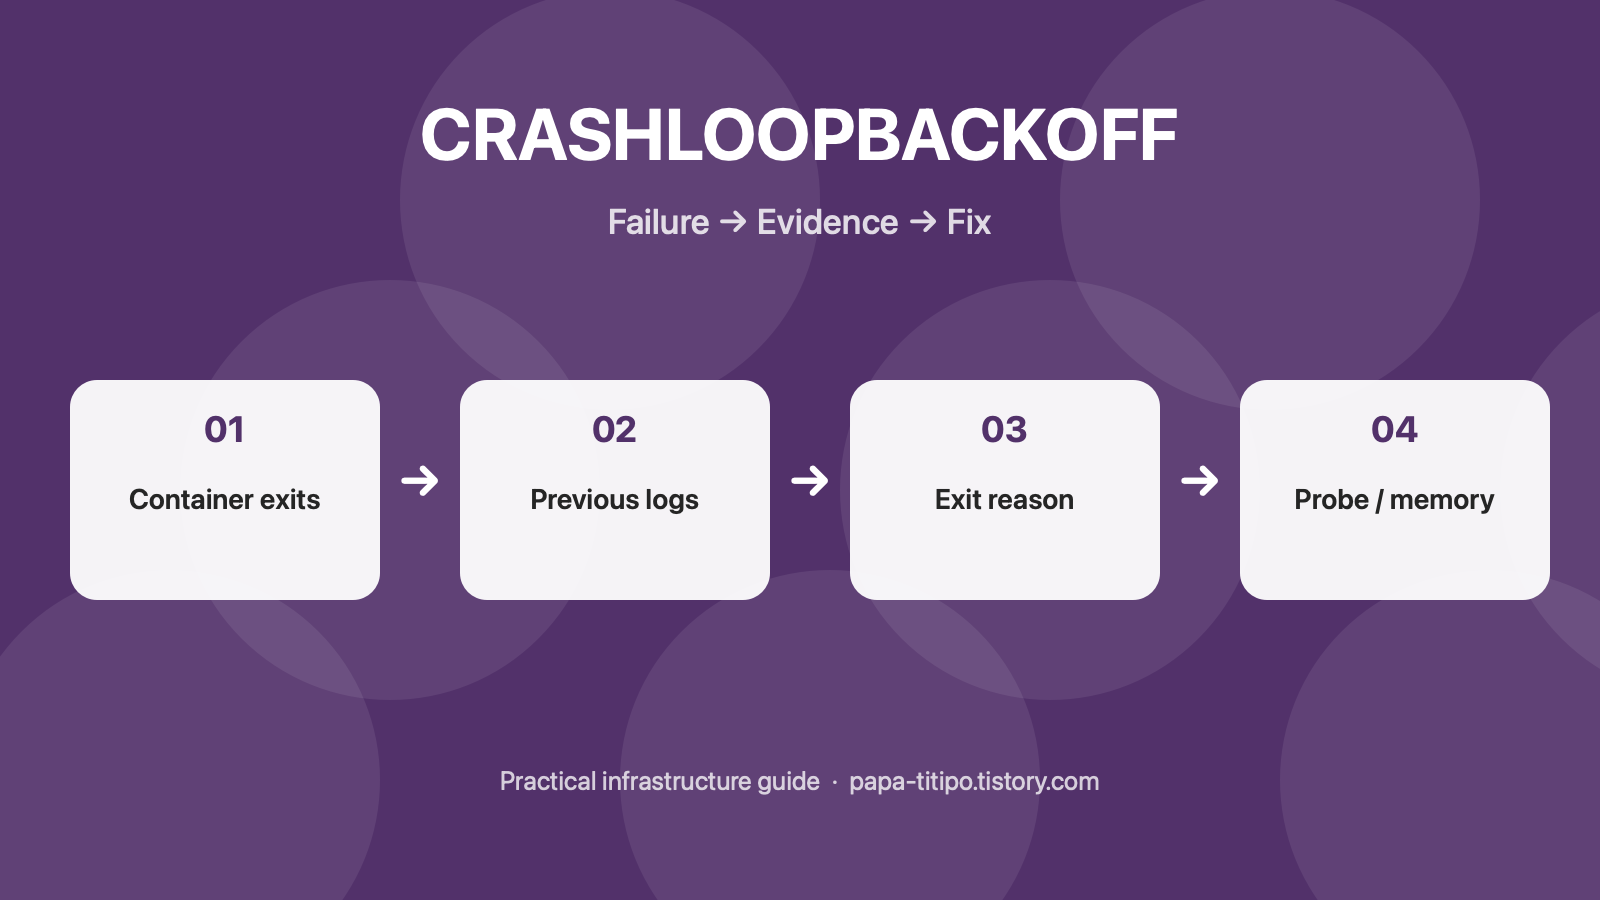
그림: 반복 재시작은 이전 실행의 종료 이유부터 확인하세요.
CrashLoopBackOff는 컨테이너가 반복 종료되어 Kubernetes가 재시작 사이 대기 시간을 늘리는 상태입니다. 하나의 원인 이름이 아닙니다. 이전 실행의 로그, 종료 이유, 이벤트를 모아야 재시작 루프를 고칠 수 있습니다.
1. 파드와 실패 컨테이너를 특정한다
kubectl get pods -n NAMESPACE
kubectl describe pod POD_NAME -n NAMESPACE
kubectl logs POD_NAME -c CONTAINER_NAME -n NAMESPACE --previous
--previous는 이전에 종료된 컨테이너 로그를 보여줍니다. 여러 컨테이너가 있으면 -c로 대상을 지정하세요. describe의 Last State, Reason, Exit Code와 Events를 같은 시각의 로그에 맞추세요.
2. 종료 이유로 진단 경로를 나눈다
| 관찰 | 가능성 | 다음 확인 |
| 앱 예외 | 설정·의존 서비스·코드 | 이전 로그와 배포 변경 |
| OOMKilled·137 | 메모리 한도 초과 가능성 | 지표·제한·힙 설정 |
| 프로브 실패 | 시작 지연·잘못된 경로 | startup/liveness 설정 |
| 설정 파일 누락 | ConfigMap·Secret·마운트 | 키와 볼륨 존재 여부 |
종료 코드만으로 단정하지 마세요. OOMKilled 상태 이유와 메모리 그래프, 노드 이벤트를 함께 봐야 합니다. 앱이 스스로 종료한 경우와 liveness 프로브가 재시작시킨 경우도 다르게 대응합니다.
3. 프로브가 너무 일찍 실패하는지 본다
DB 마이그레이션이나 캐시 준비가 길면 앱이 준비되기 전에 liveness가 실패할 수 있습니다. 실제 시작 시간을 측정하고 필요하면 startup 프로브를 설계하세요. readiness는 트래픽 수신 여부, liveness는 재시작 필요 여부를 판단합니다. 실패 횟수만 늘리면 장애 감지가 느려집니다.
4. 배포와 리소스 변경을 대조한다
kubectl rollout history deployment/APP -n NAMESPACE
kubectl get pod POD_NAME -n NAMESPACE -o yaml
kubectl top pod POD_NAME -n NAMESPACE
이미지 태그, 환경 변수, ConfigMap·Secret 참조, CPU·메모리 제한이 바뀐 시각을 기록하세요. kubectl top은 메트릭 서버가 있을 때 동작합니다. 원인을 모른 채 파드를 계속 삭제하면 이전 로그를 잃기 쉽습니다.
5. 수정 후 서비스 응답까지 검증한다
- 원인을 가리키는 로그와 이벤트를 보존합니다.
- 설정 또는 코드 한 범주만 수정합니다.
- 새 파드의 Ready 시간과 재시작 횟수를 확인합니다.
- 실제 사용자 경로를 시험합니다.
- 재발 경고를 설정합니다.
Docker 단독 실행의 종료 코드 점검은 Docker Restarting 가이드를 참고하세요. Kubernetes에서는 파드 이벤트와 프로브가 추가로 중요합니다.
6. 자주 묻는 질문
Q. 파드를 지우면 해결되나요?
설정과 이미지가 그대로면 새 파드에서도 반복될 수 있습니다.
Q. --previous 로그가 없다면?
이전 실행 이력이 없을 수 있습니다. 이벤트와 중앙 로그를 확인하세요.
Q. 프로브를 끄면 되나요?
비정상 앱 감지가 사라집니다. 경로와 시작 시간을 고치세요.
공식 자료: Kubernetes Pod 생명주기 · 파드 디버깅 (확인일: 2026-09-25)
'소프트웨어개발' 카테고리의 다른 글
| 기업용 시크릿 관리 도입 가이드: AWS Secrets Manager와 Vault 선택 기준 (0) | 2026.09.25 |
|---|---|
| 기업용 WAF 선택 기준: AWS WAF·Cloudflare 비교와 오탐·비용 체크리스트 (0) | 2026.09.25 |
| Nginx 504 Gateway Timeout 해결: upstream 응답·proxy_read_timeout·Docker 점검 (0) | 2026.09.24 |


